AIや市販ソフトを使い、画像やPDFの文字を読み取るOCR精度比較
PDFや画像の個人情報を削除する
AIに文書(PDF/画像)を渡す前に、個人情報を黒塗(墨塗)したい。
そのため、近年で有償のPDFソフトをいくつか購入した。
ジャストシステムの「JUST PDF 6 スタンダード」(旧バージョン)や、ソースネクストの「いきなりPDF Complete 13」(最新)。
PDFの個人情報の削除には、「文字認識」(OCR)と「墨塗り」(削除)機能が必要。
文字認識できないと、黒塗り削除ができないから。
そしてPDFは文字認識すると、内部のテキストと見た目の表示が別で保持される。
そのためPDFアプリでは「墨塗り」という「見た目も内部テキストも削除」する機能があるが、基本有料機能になっている。
一方、最近でてきたフリーソフト「PDF MARIN」はOCRも墨塗りも無料で可能。
Officeファイルへの変換や、テキスト編集など、欲しい機能も大抵ある。
めっちゃ便利なので、最近は「PDF MARIN」をメインで使っている。
PDF MARIN
使ってると「PDF MARIN」は結構OCR精度が高い。
内部では国立国会図書館の「NDLラボ」が公開したNDLOCR-Liteを使っており、日本語の認識力が高い。
一方、自分が持ってる有料ソフトとかでは、「いきなりAI 瞬間テキスト」(ソースネクスト)もNDLOCR系を使っているらしい。
NDLOCR-Liteの公開について
そこで、いったん市販ソフトの精度比較をしてみることにした。
ちなみに、OCRの精度だけでいえば、市販PDFソフトよりAIの方が高い。
しかしAIに情報を渡す前の処理として、AI以外で「OCR+墨塗り」による個人情報が必要なんだな。
※自分はGWSスタンダード版でエンタープライズ保護あり(AIモデル学習なし)も使ってるが、なるべく個人情報は一応抜いてる
Geminiの履歴オンのために個人でGoogle Workspace Standardを契約した
今回は、AIと市販PDFソフトのOCR精度比較もしてみた。
OCR精度比較の観点
比較に使ったPDFは1ファイル(3ページ)のみ。
お時間がにゃーので。
なるべく質が悪い手元のPDFを探して、昔の賃貸契約(解除)をスキャンした文書が出てきた。
不動産屋が、その先の清掃業者からFAXでもらった見積書を含む、賃貸契約解除系のファイル。
3ページのうち1ページは元がFAXなので、画像が粗い。
例えば以下は、目視でも判読が難しい箇所がある。
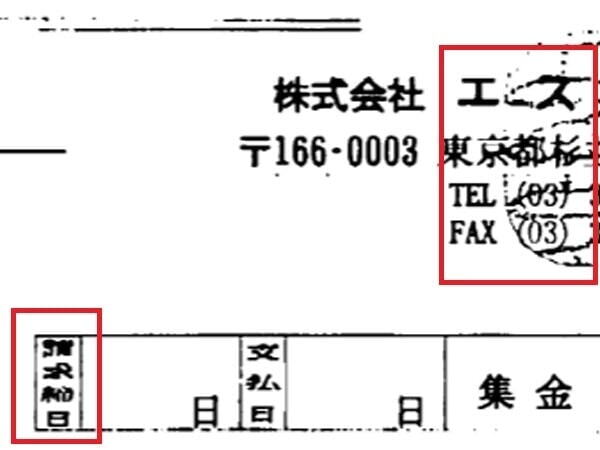
- 印鑑と文字が被ってて文字認識が難しい
- 縦組みの文字
- 小さなサイズの漢字が潰れて判読不能
以下のあたりも、判読が難しそう。
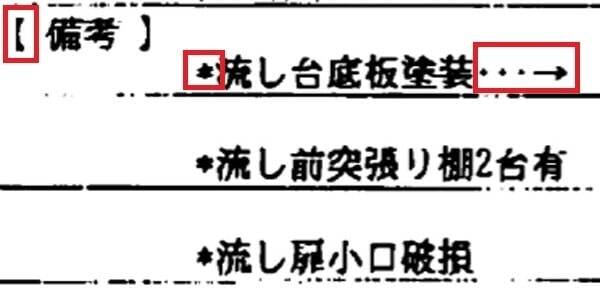
- 装飾文字、記号
- 表形式(費目と価格と備考)
FAXのヘッダーみたいな、省略表現もある。
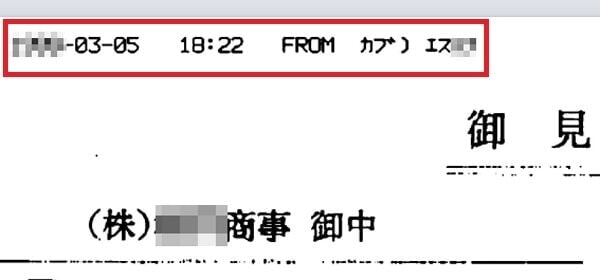
- 全角で「カブ)」というFAX的な省略表現
- ちなみに文書内には半角カナも含まれる
このあたりを、どこまで文字認識できるか?
ちぇけちぇけ
OCR精度比較(市販ソフト)
OCR専用ソフトではなく、PDFソフト系での比較となる。
対象は、たまたま自分が持ってるソフトの範囲のみ。
従来の市販ソフトでは、OCRエンジンとしてABBYY(ロシア系)を使っているモノが多いようだ。
ソースネクストの「いきなりPDF」シリーズは、バージョンによりエンジンが異なる場合もあるが、ver13はABBYY。
一方で、最近だとNDLOCR系を使うPCソフトも徐々に増えてきている。
| 比較観点 | PDF MARIN | いきなりAI 瞬間テキスト | JUST PDF 6 スタンダード | いきなりPDF COMPLETE13 |
|---|---|---|---|---|
| 採用エンジン | NDLOCR-Lite | NDLOCR系 ※一括処理時 | ABBYY FineReader | ABBYY FineReader |
| 印鑑被り・網掛け | ✕ | ✕ | ✕ | ✕ |
| かすれ・潰れた漢字 | ◯ | △ | ✕ | ✕ |
| 標準テキスト | ◎ | △ | △ | △ |
| 特殊文字・記号 | ◎ | ✕ | ✕ | ✕ |
| 原本への忠実さ | ◎ | ◎ | ◎ | ◎ |
| 文脈推測・補完力 | ✕ | ✕ | ✕ | ✕ |
| 捏造リスクの低さ | ◎ | ◎ | ◎ | ◎ |
| エラーの明示 | ◯ | ✕ | ✕ | ✕ |
| 元の配置の維持 | ◯ | ✕ | △ | △ |
「印鑑被り・網掛け」については、全ソフトが「×」だが、↑図のような印影と被った文字は全ソフト認識できなかった。
元文章:管理No 89387 ※上から「管理部」の印鑑が被っている箇所
PDF MARIN:T理No. 89387
JUST PDF 6:• •・ニ書郵0* 89387

※文字の上に印鑑が乗っているだけで、市販ソフトは輪郭が抽出できず激しく文字化けしてしまう
ちなみに、AIだとこれも文字認識できる(後述)。
「原本への忠実さ」「文脈推測・補完力」「捏造リスクの低さ」は、AIだと「不明な文字を推測した結果、間違える」ということがある。
市販のPDFソフトだとそういう問題は起きない。
逆にPDFソフトは「文脈推測・補完力」がない。
「エラーの明示」は、文字認識できなかった箇所の提示やスコアリング。
唯一、「PDF MARIN」は原本と重ねながらOCR結果をチェックしたり、精度のスコアリング結果をみることができる。
つまり、自動でOCRした後に目視チェックしながら修正するのが非常に簡単。
「元の配置の維持」は、縦組み・横組み・表などを、コンテンツに併せてテキスト化できるか。
例えば表の2つのセルのテキストを、別々の文字列として認識してテキスト化できるか。
ここら辺も、「PDF MARIN」が強かった。
結果としては、この中では「NDLOCR-Lite」を採用した「PDF MARIN」が一番優秀だった。
「NDLOCR-Lite」は国会図書館由来だけあって、かすれた文字なども含め、低解像度の文字認識に強いらしい。
ディープラーニング(深層学習)でその問題を解決してるのが、NDLOCRの特徴。
一方、ジャストシステムやソースネクストが使っているABBYY。
表や段組などのレイアウト理解なども含めた高性能OCRエンジンだが、文字認識のベースは「白黒コントラストでのパターンマッチング依存」のため、かすれ文字や用紙の汚れ、ノイズにはちと弱いらしい。
そこがDLを使ったNDLOCRとの違いになってくる。
元文章:(賃料+管理費)÷31日割×3日分
PDF MARIN:(質料+管理費)÷31日割×3日分
JUST PDF 6:(賃料 +管理費)+31日割X 30分

※JUST PDF 6は割り算記号が「+」になり、「3日」が「30分」になるなど致命的なエラー)、ノイズが乗った細かい文字や記号に対し、従来型ソフトは対応に苦慮
OCR精度比較(AI)
個人情報を墨塗りした上で、AIでも比較してみた。
AIとのチャット画面でPDFを添付いて、「テキスト化して」と言えば文字抽出したテキストをくれる。
最初に結論をいうと、一番認識力が高かったのはGemini Pro 3.1で圧倒的だった。
しかしclaude(web)はsonnet 5.5を使ったり、ChatGPTもフリー版のwebチャットを使ったり、モデルのレベルはバラバラ。
自分はclaudeはAPI都度課金でしかた使ってないので、この手のテストに使うのは勿体ないというか…。
その上で、市販ソフト・AIのOCR結果をGemini Pro 3.1に読み込ませて、評価させた結果が本稿となります。
一番正解を知ってるのが、geminiだったので(今回は)。
なおAIのモデルについて、I/Fは下記のモデルだが、OCRの際に内部でどのモデルを使っているかは不明。
そのためモデル表記は参考程度にて。
| 比較観点 | Gemini | ChatGPT | Claude |
|---|---|---|---|
| 採用エンジン | Gemini Pro 3.1 (内部不明) | GPT-6 (内部不明) | Sonnet 5.5 (内部不明) |
| 印鑑被り・網掛け | ◎ | ✕ | △ |
| かすれ・潰れた漢字 | ◎ | △ | △ |
| 標準テキスト | ◎ | ◯ | ◯ |
| 特殊文字・記号 | ◎ | ◯ | ◯ |
| 原本への忠実さ | ◯ | ✕ | △ |
| 文脈推測・補完力 | ◎ | ◯ | ◯ |
| 捏造リスクの低さ | ◯ | ✕ | △ |
| エラーの明示 | △ | ◯ | ◎ |
| 元の配置の維持 | ◯ | △ | △ |
AIは市販ソフトのOCRエンジンと異なり、「文脈と言語的推測」による補完が入ってくる。
極端に言うと、目視で潰れて見えない文字でも補完可能だが、その代わりにその推測が外れるリスクもでてくる。
そこら辺のリスクに対するスタンスが、AI間の違いとして出てきたりもする。
例えば、一番手堅いソースを書くことで有名なClaudeは、文書もやっぱり手堅く処理してた。
文字認識が難しい部分はあえて推測せず、「不明箇所は[]で埋めました」という結果がでてきた。
また、「これをテキスト化して」というざっくり指示に対して、最初から注釈付き(文字認識の怪しい箇所)で結果がでてきた。
元文章:クロスハギ手間下地処理
Claude:クロスハガ手間下地処理
添えられた注釈:「※クロス・クロスハガ等の一部表記は不鮮明なため推定です。」

※かすれて読めない部分を適当に処理せず、ユーザーに「ここは怪しいから確認してね」とアラートを出してくれる。ChatGPTは、文脈から単語を予測して外してくるという、ハルシネーションが最も多かった。
これは文脈理解力が高い特性とのトレードオフかもしれない。
元文章:【塗装工事】
ChatGPT:浴室工事

元文章:クロスハギ手間下地処理
ChatGPT:クロスパテ・手間下地処理

※かすれて読めない部分を、前後の「工事」や「クロス」という文脈から、勝手に別の建築用語を作り出して(捏造して)しまった。Geminiは、基本的に文字認識の精度が高い。
これは最初から画像、テキスト、音声などマルチモーダルで学習させている点が、他のAIと異なる。
そのため、画像分析(ノイズを含む視覚的な特徴)と文脈分析による統合的な予測が、OCRの精度の高さででてくるらしい。
これはGeminiの自己評価の言だが。
まとめ
以下、個人の感想です。
- PDFで個人情報削除を無料でするなら、「PDF MARIN」が便利
- 個人情報削除済みのPDFからOCRしたいなら、Geminiが便利
- OCRするだけなら、市販ソフトよりAIの方が精度が高い(ハルシネーションに注意)
ほい。
そんな感じ。